人像加人聲,生成對口型影片
用一張人像和一段人聲做成對口型短片。說話或唱歌都保持口型同步,時長限制在 3–30 秒。
用口型同步影片,把一張人像和一段人聲做成說話或演唱短片。上傳一張清晰正臉,加上 3–30 秒人聲,即可線上生成 AI 對口型影片。
用靜幀人像和清晰人聲生成 AI 對口型影片:口型全程同步、只收一張臉,畫幅可直接發平台。
用一張人像和一段人聲做成對口型短片。說話或唱歌都保持口型同步,時長限制在 3–30 秒。

上傳一張 JPG、PNG 或 WebP 人像(最大 50MB),或選用角色預設。提示詞必填——可用「靈感」或「套用靈感」起個頭。
可選 1:1、16:9、9:16、4:3 或 3:4,按 768P 或 1080P 出片,方便發 Shorts、Reels 或橫式內容。
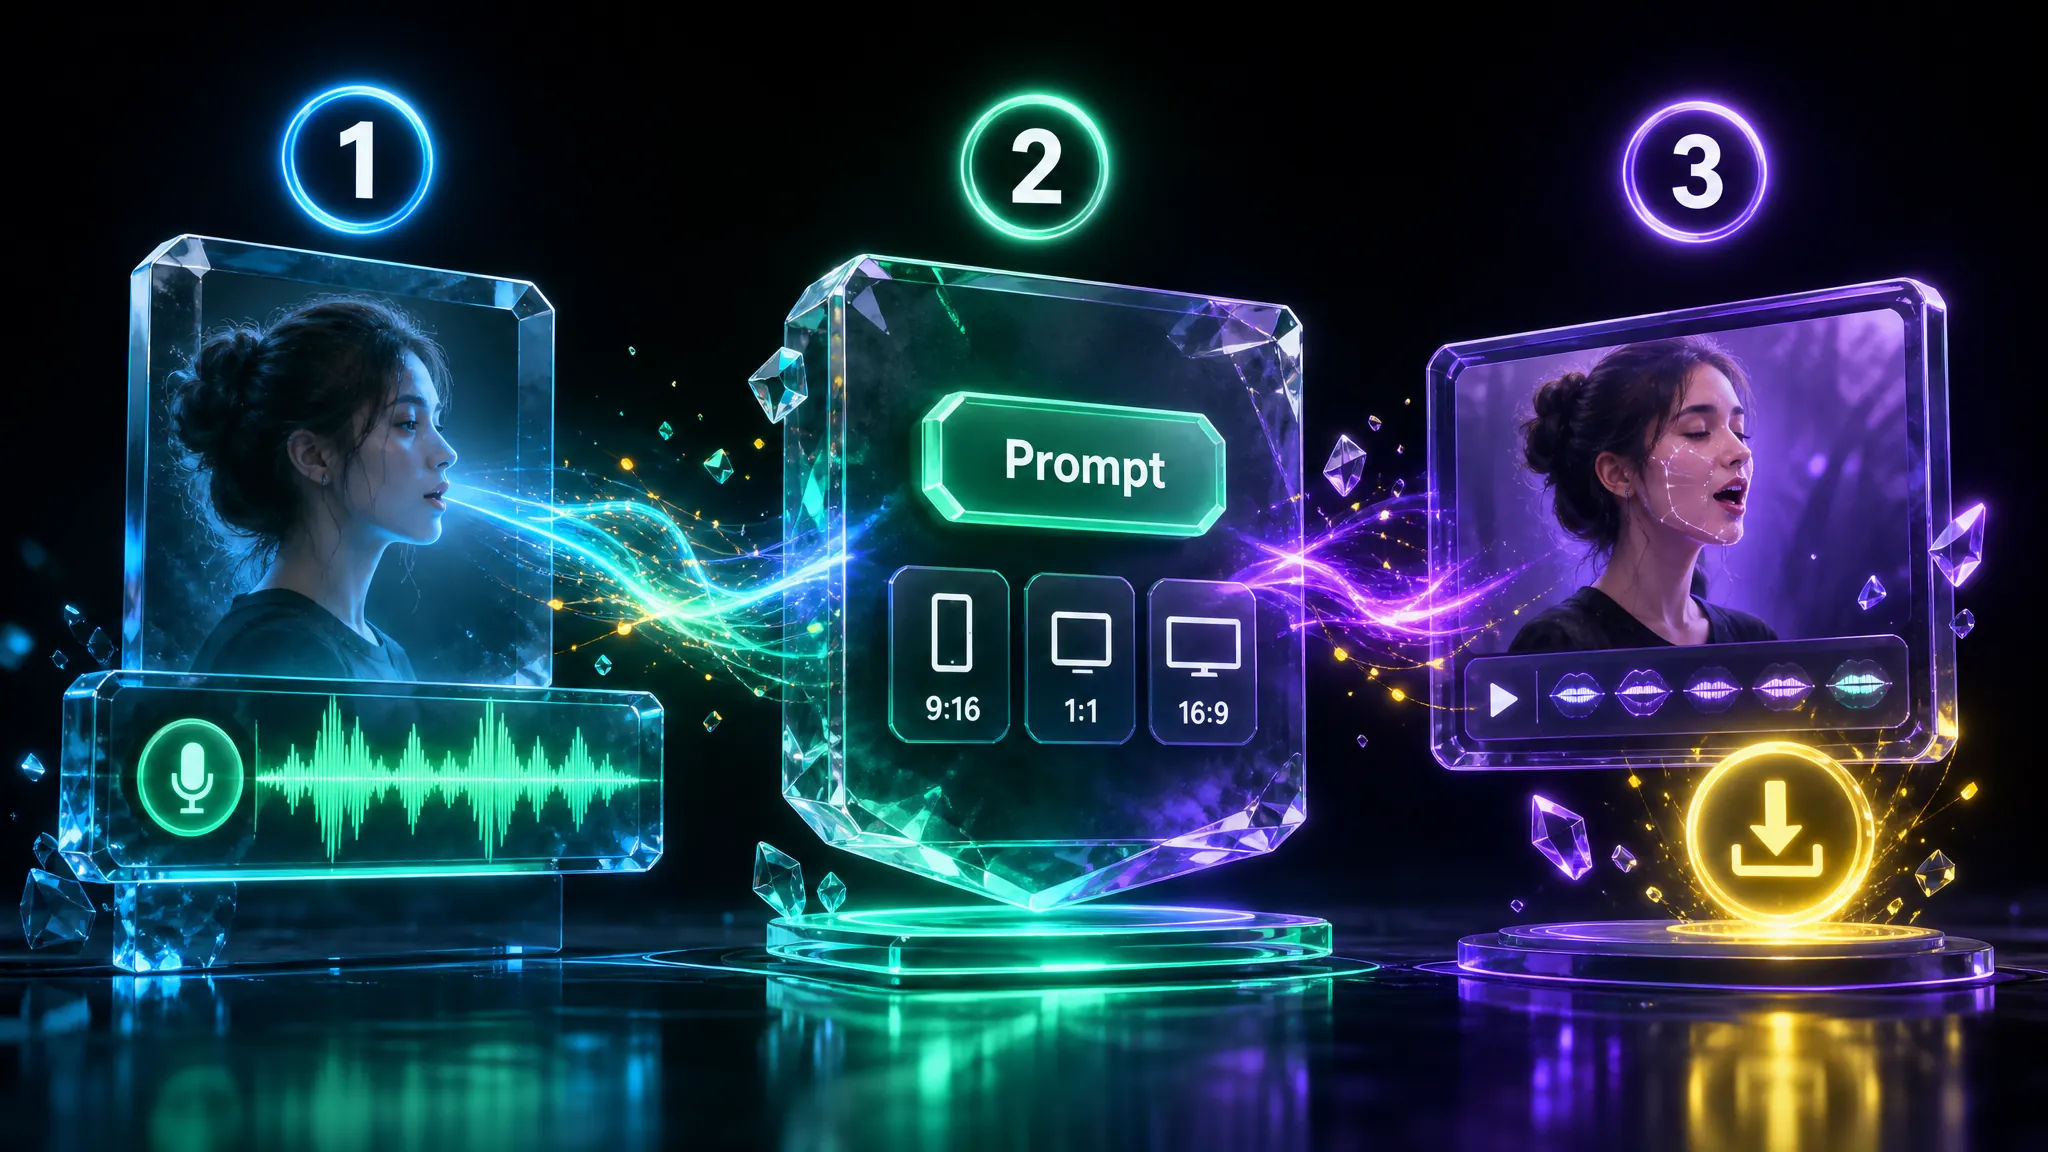
加入一張人像和人聲音訊,寫好提示詞,選好畫幅和解析度,再點擊創作。片段須在 3–30 秒。「線上免費」指可用現有點數試用,不是無限免費生成。對口型通常幾分鐘出片。需登入並消耗點數。
從新聞口播、Podcast 出鏡到演唱短片,都是一張人像加清晰人聲的實用流程。
把發言人像對上短口播,做出新聞或解說片,不必整場實拍。
把問答人聲做成談話出鏡,用於面試演練、來賓介紹或模擬作答。
用主持人像配講解音軌,做 Podcast 預告或課程開場。
用人像對上歌曲人聲,做成 AI 對口型演唱短片,適合副歌、翻唱和短表演。
讓藝人像在錄音室麥克風前唱副歌、topline 小樣或人聲鉤子,做成發歌預告和社群宣傳。
口型預設開啟、瀏覽器裡完成、歷史紀錄可續做,點數規則寫清楚——不承諾幫現成影片配音,也不承諾無限免費。
創作者怎麼把人像對上人聲做說話或演唱短片——不是每次一遍過,但夠快,能交出一條短表演。
"傳了一張清晰正臉加 14 秒口播,4:3、768P。第一遍偏僵,提示詞改軟一點,第二遍就能當新聞預告用了。"
Blair T.
"把「我的音樂」裡的人聲裁到 22 秒。有個子音慢半拍,但草稿已經能發出去了 🎙️"
Keiko
"角色預設加面試音訊,9:16。結果頁預覽夠乾淨,當天就發了。"
Micah D
"拿成品曲做演唱片段。先得切掉純伴奏前奏,只要人聲。第二次創作副歌口型才穩住。"
Quinn Adler
"提示詞用了「套用靈感」,再升到 1080P 試了一次——點數挺肉疼。打草稿還是用 768P。"
Soren Hale
"生成時離開了頁面,後來在歷史紀錄裡找到任務。這不是幫現成影片改嘴——就是人像加音訊,正是我要的 🔥"
Imani Reyes
關於素材、時長、點數,以及本頁和照片視頻製作器有何不同,直接回答。
這裡的 AI 對口型,是用一張靜幀人像和一段人聲音訊生成對口型影片。MusGen 會讓口型跟上說話或演唱。這是「照片 + 音訊」的對口型,不是拿現成臉部影片去改嘴。
不是。這個對口型流程只接收一張人像和音訊。本頁不能上傳人臉影片做配音、翻譯或多說話人換嘴。
加入一張人像和人聲音訊,寫提示詞,選好畫幅和解析度,再點「創作」。先把音訊裁到 3–30 秒。可在「結果」或歷史紀錄裡預覽。
圖片:JPG、PNG 或 WebP,最大 50MB,且須一張清晰完整的臉。音訊:MP3、WAV、AAC 或 M4A,最大 30MB。請用人聲清楚的素材,不要純伴奏。
每條任務必須在 3 到 30 秒之間。更長的音訊要先裁再創作。
是的。生成需要登入,點數按時長乘以解析度計算(768P 與 1080P 的單價,新用戶和回訪用戶不同)。部分會員方案還有每日任務上限。
可以。從「我的音樂」選已完成的曲目,或上傳本機人聲檔,再裁到 3–30 秒。
「線上免費」指你可以打開工具,用現有點數試用。不等於無限免費生成、免費商用授權,或免登入生成。
口型同步影片一律用一張人像和人聲,做成口型對齊的說話或演唱短片。照片視頻製作器是把照片做成音樂影片,對口型只是可選項。想做照片 MV 請用照片視頻製作器。
加上人像和清晰人聲,在上方工具裡做出說話或演唱短片。
開始口型同步影片